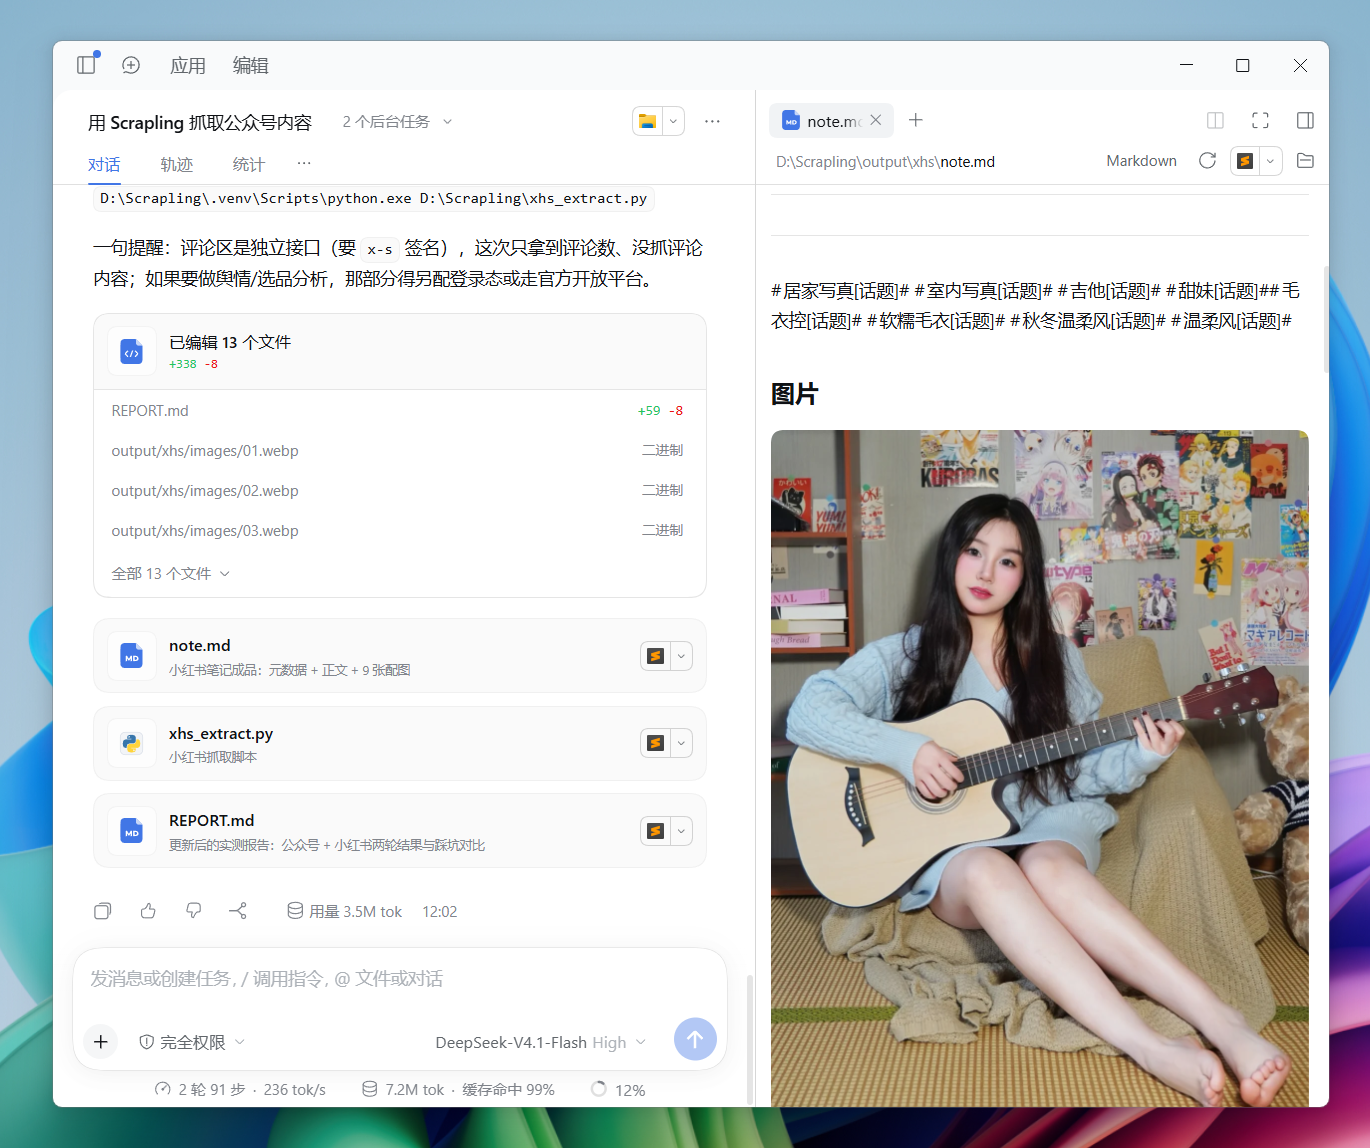
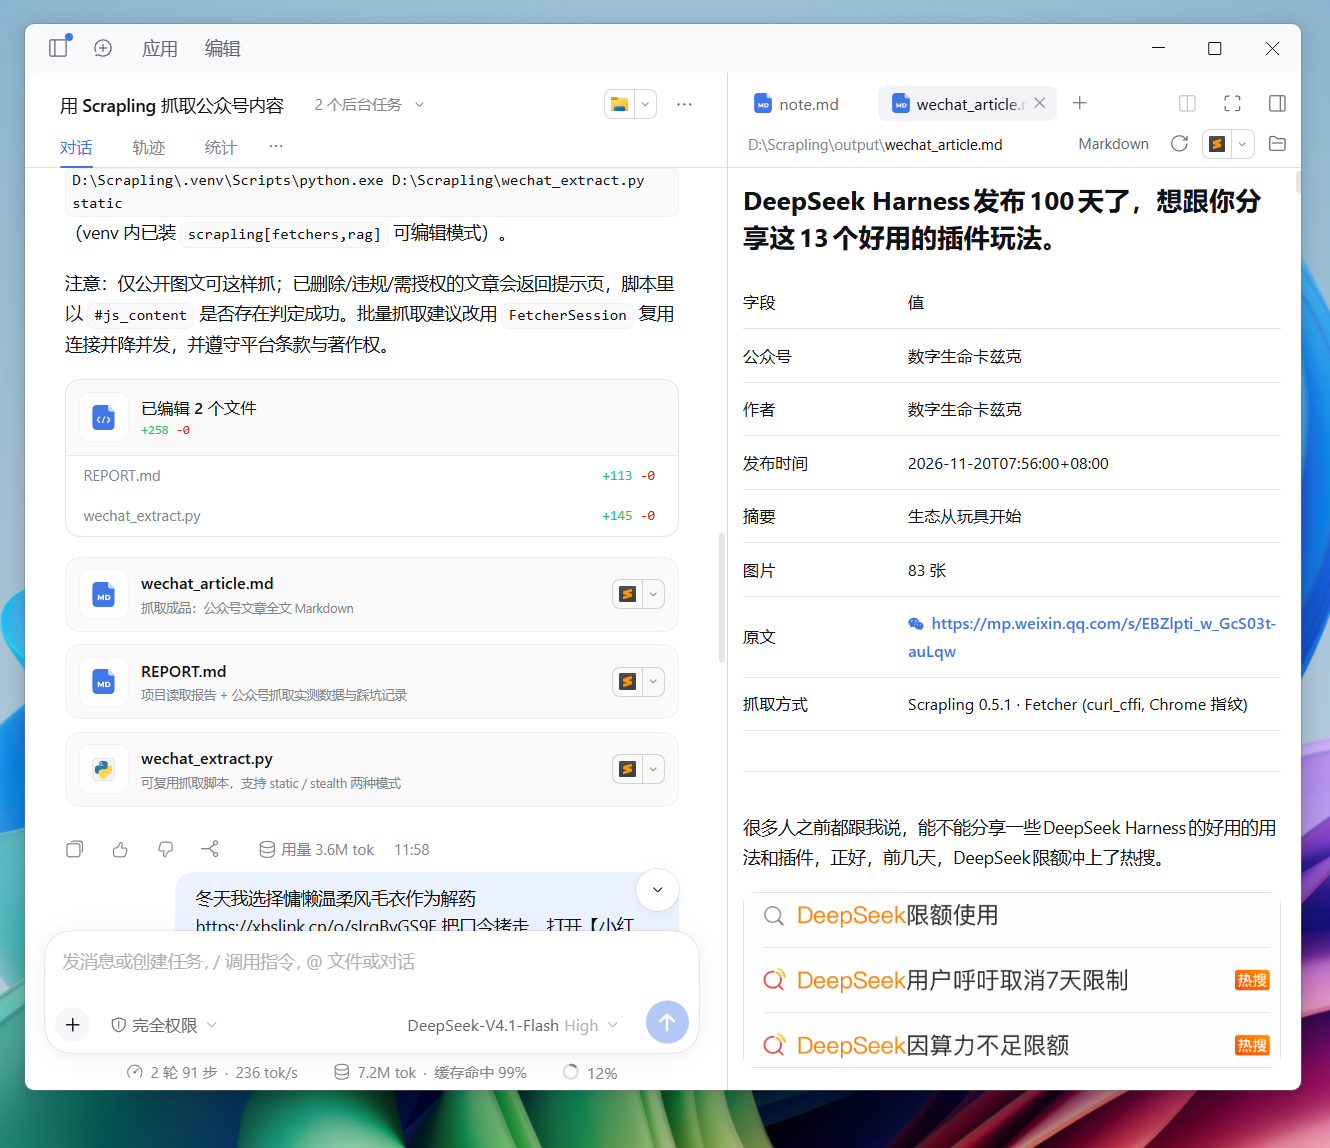
Scrapling 是一种 Python Web Scraping 框架,它将快速 HTTP 请求、隐形浏览器、强大的解析和并发爬虫集成到一个库中。抓取静态页面、渲染 JavaScript、与网站交互,并从其背后的 API 调用中提取数据。
构建具有可重用会话、代理轮换、自动重试、暂停/恢复和内置数据导出的爬网程序。从 Python、终端或您的 AI 代理通过其 MCP 服务器和代理技能使用它。从提取几个字段到将整个网站收集为干净的 Markdown,Scrapling 涵盖了完整的抓取工作流程。